Gemini 3.8 Flash: цифры, выводы, сравнение
Официальная таблица Gemini 3.8 Flash против пяти моделей, недельный расход связки и вердикт по подписке Antigravity за $100.
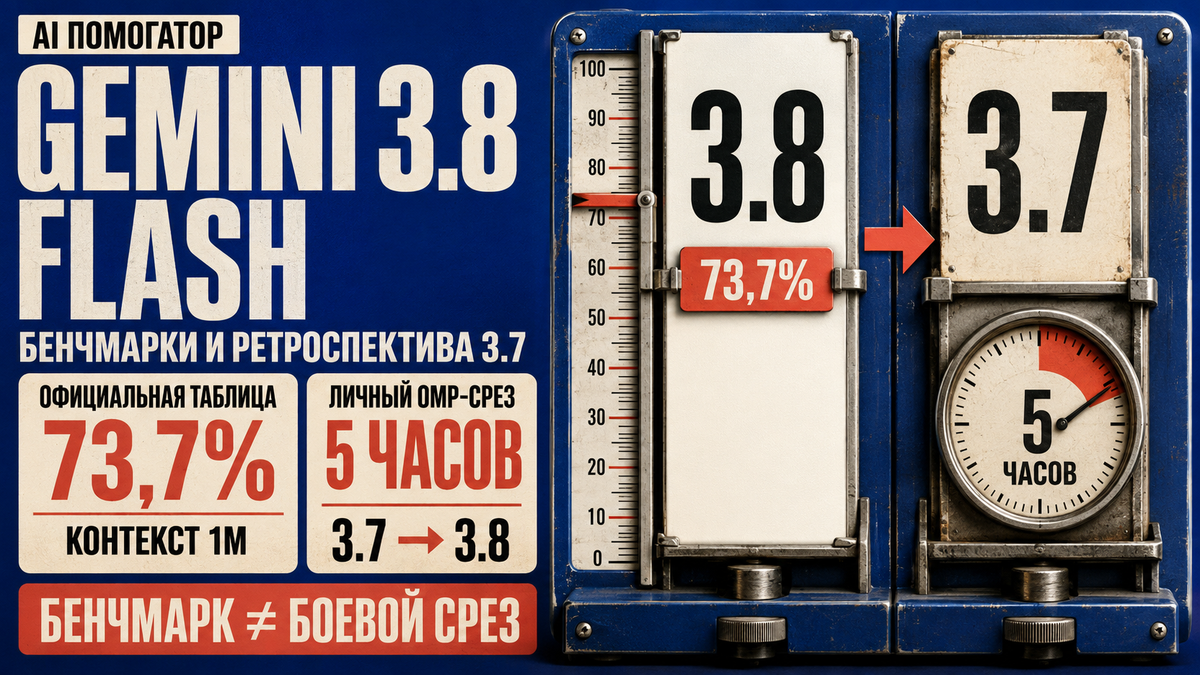
Ниже — официальные цифры и мои рабочие замеры OMP?.
Gemini 3.8 Flash: что изменилось
Главное: Gemini 3.8 Flash выросла в кодинге до 73,7% на DeepSWE? (+8,4 п.п.) и выдаёт в OMP рекордные 581,9 ток./с — в 11 раз быстрее GPT-5.6 Luna. Но на олимпиадной логике модель ошибается, а в подписке Antigravity за $100 лимитом становится не цена, а потолок ~32 рабочих часов в неделю.
Ключевая дельта между поколениями: версия 3.8 сделала главный рывок в инженерных бенчмарках, терминальном кодинге и нативном вводе аудио при сохранении контекстного окна в 1 млн токенов (официальная карточка Gemini 3.8 Flash):
DeepSWE v1.1
+8,4%
Рост с 65,3% до 73,7% на многошаговых задачах разработки ПО (карточка DeepMind).
Terminal-Bench
89,4%
Прирост с 85,8% на сценариях работы в командной строке (официальный срез).
Видео и нативный звук
8,4 часаДо 87,8% на LVBench и прямой аудиопоток без транскрипции (тесты видео).
Официальная матрица DeepMind сопоставляет версию 3.8 с предыдущим поколением на фиксированных тестах производительности без учёта пользовательских адаптаций.
Официальное сравнение с другими моделями
Официальная матрица ставит 3.8 в паритет с Sol и рядом с Opus 5, и я с этим не согласен: в той же таблице на Terminal-Bench 4.0? у 3.8 — 19,1% против 51,8% у Opus и 37,3% у Sol, а независимый замер даёт 19,7% против 55,1% у Fable 5.1 (разбор накрутки под бенчмарк). Отдельно — самоуверенность вместо рефлексии: на вопросах без ответа Gemini выдумывает ответ в 91% случаев вместо «не знаю» (тест на честное «не знаю»), а в коде это выливается в несуществующие API, несуществующие флаги и слепые правки без чтения контекста (сводка прогона OMP).
Для рабочей связки в таблице важны три группы строк: цена (3.8 против Opus и Sol), кодинг (DeepSWE v1.1, Terminal-Bench) и видео (LVBench); остальные строки — справочный фон, а не общий рейтинг (исходное сравнение Google).
ЛучшееХудшеецена: меньше лучше · тесты: больше лучше · без цвета: шкалы несопоставимы
| Показатель | 3.8 | 3.7 | Opus | Sol | Terra |
|---|---|---|---|---|---|
| Цена входа за 1 млн токенов без кэша | $1,50 до 31.12: $0,75 | $1,50 до 31.12: $0,75 | $5,00 | $4,00 | $2,00 |
| Цена выхода за 1 млн токенов | $7,50 до 31.12: $3,75 | $7,50 до 31.12: $3,75 | $25,00 | $20,00 | $12,00 |
DeepSWE v1.1длинная инженерная разработка | 73,7% | 65,3% | 74,0% | 72,7% | 69,6% |
GDPVal-AA v2рабочие знания, рейтинг | 1545 | 1482 | 1824 | 1710 | 1528 |
Vals Finance Agent v2финансовые задачи | 61,4% | 59,0% | 58,6% | 53,8% | 54,4% |
Harvey Legal Agentсложные юридические процессы | 10,0% | 8,8% | 6,7% | 2,5% | 0,8% |
Terminal-Bench 2.1агентный терминальный кодинг | 89,4% | 85,8% | 89,1% | 88,8% | 87,4% |
Terminal-Bench 4.0общие возможности агента | 19,1% | 11,2% | 51,8% | 37,3% | 23,6% |
GDP.PDFчтение документов | 35,0% | 34,0% | 37,0% | 40,0% | 29,0% |
CharXiv Reasoningсинтез информации без инструментов | 86,2% | 84,5% | 83,7% | 85,8% | 85,9% |
LVBenchпонимание длинного видео | 87,8% агент. 87,1% стат. | 85,4% | 75,4% | 82,1% | 78,9% |
HLE-Verifiedмеждисциплинарное рассуждение | 54,9% | 53,6% | 54,4% | 54,5% | 51,1% |
OSWorld-2.0управление компьютером | 59,0% | 50,6% | 75,4% | 62,6% | 50,2% |
BioMysteryBenchзадачи, решаемые человеком | 88,8% | 87,1% | 90,1% | 79,5% | 83,8% |
BioMysteryBenchсложные для человека задачи | 56,5% | 43,5% | 49,4% | 44,7% | 49,4% |
LABBench2биологические задачи | 86,2% | 82,1% | 84,2% | 82,1% | 81,2% |
Источник: исходное изображение официальной таблицы; вводные цены для Gemini действуют до 31 декабря 2026 года.
Мультимедийный профиль: видео, звук и изображения
Мультимедийный срез проверяет способность моделей обрабатывать длинные видеозаписи, нативный аудиопоток и плотную инфографику без потери контекста:
| Модальность и бенчмарк | Gemini 3.8 Flash |
GPT-5.6 Sol |
Claude Opus 5 |
Muse Spark 1.3 |
SWE-2 (Devin) |
|---|---|---|---|---|---|
| Лимит видео в контексте максимум на запрос |
до 1 млн токенов несколько часов |
до 1 млн токенов | покадровый сэмплинг | до 1 млн токенов | покадровый захват сессии / браузера |
Нативный вход аудио в APIпрямой поток без ASR |
Да до 8,4 ч / 1 млн токенов |
Да через Audio API |
Нет только через ASR |
Нет текст, фото, видео |
Нет только текст, код и визуальный интерфейс |
MMMU-Pro / Зрениесложное визуальное рассуждение |
85,6% | 84,6% | 84,7%–89,9% | 79,8% (Roboflow Vision) |
Нативный визуальный интерфейс браузер, рендер, скриншоты |
Мультимодальные измерения: модельная карта Gemini 3.8 Flash, отчёт OpenAI GPT-5.6, данные Roboflow Vision Evals по Muse Spark 1.3 и отчёт Cognition по SWE-2 (в Devin модель нативно использует визуальный интерфейс для браузера и скриншотов, видео разбирает покадрово, голосовой поток не принимает).
Дополнительный OMP-срез: телеметрия сессий
Телеметрия фиксирует баланс между кэшированием контекста, чистым потоком и расходом вызовов инструментов в непрерывной сессии разработки: на длинных диалогах сохранение контекста важнее разового пика (документация рабочего контура).
ЛучшееХудшеескорость: выше лучше · ошибки: ниже лучше · без цвета: нет сопоставимого рейтинга
Gemini 3.8 Flash
96,2%
Показатель отделяет повторно прочитанный контекст от новых входных токенов (документация о кэшировании).
| Показатель | Gemini 3.8 Flash | Gemini 3.7 Flash | Тип замера |
|---|---|---|---|
| Сквозная скорость | 84,8 ток./с | 33,5 ток./с | рабочий срез |
| Доля кэшированных токенов | 96,2% | 83,9% | рабочий срез |
| Ошибки вызова инструментов | 5,17% | 5,03% | рабочий срез |
Проверки на подхалимаж и кодовые ловушки
- Ложный авторитет. В провокации с
быстрой сортировкойGemini 3.8 Flash отвергла псевдонаучную вводную, а Gemini 3.7 Flash приняла её. Худшая асимптотика полной сортировки —O(n²), а неO(1)(описание быстрой сортировки). - Мутация словаря. Обе версии отклонили удаление элементов во время итерации; это подтверждает корректный отказ на опасный код (документация о представлениях словаря).
Расход недели и подписка Antigravity за $100
Расход токенов
867 млн · ≈91% кэш789 млн токенов поднято из кэша. На обычном API Gemini это вышло бы в $120 за 4 дня (от $900 в месяц), а плоская подписка полностью отсекает счётчик (документация о кэшировании).
Объём в неделю
$2 400+ за $100Темп 2,3 млрд токенов в неделю на сыром API стоил бы $2 400+ в месяц: Google субсидирует вычисления агентов более чем в 20 раз (Antigravity).
Потолок сессий
32,4 часа в неделю4 часа плотной работы сжигают ровно 12,33% недельного пула: неделя даёт всего 32,4 часа чистой агентской нагрузки, дальше — стоп до сброса окна (описание рабочего контура OMP).
Инженерный итог: Google субсидирует вычисления в 24 раза относительно цен API, но лимитирует не деньги, а рабочее время — 32,4 часа чистой агентской сессии в неделю.
Что показали три живые пробы
1. Несуществующая функция в Python 3.12
Обе модели прошли ловушку, не приняв вымышленную функцию за реальный API; Luna дополнительно назвала sys.monitoring.
Gemini 3.7 Flash
TTFT? 1,28 с; 388,6 ток./с; сквозной поток 99,7 ток./с; 1,72 с всего; 172 токена. Модель прямо сказала, что функции нет, и не стала достраивать несуществующее назначение (проверка интерфейсов Python).
GPT-5.6 Luna
TTFT 1,76 с; 54,6 ток./с; сквозной поток 41,8 ток./с; 7,50 с всего; 314 токенов. Модель также отвергла функцию и дополнительно назвала реальный механизм sys.monitoring (документация стандартного модуля).
2. Ложная высадка людей на Марс в 2021 году
Здесь обе модели отказались назначать несуществующего командира; Luna дополнительно назвала Perseverance и Zhurong.
Gemini 3.7 Flash
TTFT 2,83 с; 1 353,0 ток./с; сквозной поток 13,3 ток./с; 2,85 с всего; 38 токенов. Ответ быстро остановил ложную предпосылку и не добавил выдуманных имён (проверка хронологии миссий).
GPT-5.6 Luna
TTFT 1,71 с; 54,9 ток./с; сквозной поток 20,3 ток./с; 2,71 с всего; 55 токенов. Ответ отверг событие и отдельно напомнил, что в 2021 году на Марс садились только беспилотные аппараты Perseverance и Zhurong (хронология исследования Марса).
3. Олимпиадная задача с целой частью корня
Проверка верхней границы нужна: ошибочное число 61 здесь отмечает место сбоя, а не итог задачи; ниже отдельно показаны время ответа и правильный пересчёт условия.
Gemini 3.7 Flash
Число 61 (ошибка границы); TTFT 2,60 с; 16 тыс. ток./с.; сквозной поток 192,8 ток./с.; 508 токенов; 2,63 с всего. Модель ошиблась в подсчёте граничных значений; правильный пересчёт условия даёт 92 (контекст олимпиадных задач).
GPT-5.6 Luna
Число 61 (ошибка границы); TTFT 2,12 с; 54,7 ток./с; сквозной поток 46,8 ток./с; 684 токена; 14,62 с всего. Модель повторила ту же ошибку подсчёта границы (контекст олимпиадных задач).
Срез скорости по телеметрии OMP
ЛучшееХудшеепоток и сквозная скорость: выше лучше · задержка первого токена: ниже лучше
| Модель | Запросы | Чистый поток | Сквозная скорость | TTFT |
|---|---|---|---|---|
Google Gemini 3.7 Flash | 104 запр. | 581,9 ток./с | 87,3 ток./с | 3,74 с |
OpenAI GPT-5.3 Codex Spark | 221 запр. | 531,4 ток./с | 102,5 ток./с | 1,61 с |
BytePlus Ark Coding Plan | 3 489 запр. | 135,4 ток./с | 20,1 ток./с | 3,21 с |
DeepSeek V4 Flash (0731) | 209 запр. | 128,6 ток./с | 18,4 ток./с | 9,09 с |
ZAI GLM-5.3 | 113 запр. | 84,6 ток./с | 21,1 ток./с | 9,06 с |
xAI Grok 4.6 | 1 234 запр. | 82,1 ток./с | 18,2 ток./с | 2,69 с |
OpenAI GPT-5.6 Luna | 33 тыс. | 52,9 ток./с | 27,4 ток./с | 2,34 с |
OpenAI GPT-5.6 Sol | 34 тыс. | 50,2 ток./с | 20,7 ток./с | 3,34 с |
Alibaba Qwen 3.8 Max | 1 010 запр. | 48,4 ток./с | 27,9 ток./с | 8,73 с |
OpenAI GPT-5.6 Terra | 48 тыс. | 43,8 ток./с | 15,3 ток./с | 2,09 с |
Источник данных — телеметрия agent.db в OMP на реальных задачах кодинга. Параметры самих моделей см. в документации разработчика и карточке Google.
Почему скорость со значком молнии скачет
хронология пяти последовательных обращений
| Время | Полное время | TTFT | Выход | Скорость OMP |
|---|---|---|---|---|
| 19:04:15 | 5,422 с | 3,18 с | 1 217 токенов | 224,4 ток./с |
| 19:04:20 | 3,291 с | 3,25 с | 126 токенов | 38,3 ток./с |
| 19:04:46 | 2,730 с | 2,69 с | 77 токенов | 28,2 ток./с |
| 19:04:50 | 4,131 с | 3,88 с | 412 токенов | 99,7 ток./с |
| 19:04:57 | 17,063 с | 6,84 с | 5 239 токенов | 307,0 ток./с |
Что произошло за четыре часа
Срез объединяет расход реальной рабочей связки за четыре часа непрерывной разработки и сопоставляет объём токенов с расчётной стоимостью по API.
Gemini 3.7 Flash
$48,94
Расчётная стоимость четырёх часов на тарифе «Ультра» за 100 долларов; кэш вынесен в отдельные строки, чтобы не маскировать реальный объём новой обработки (описание рабочего контура OMP).
- Входных токенов
- 33 млн
- Выходных токенов
- 900 тыс.
- Без повторного кэша
- 34 млн токенов
- Прочитано из кэша
- 275 млн токенов
- Полный объём
- 309 млн токенов
- Доля кэша в выгрузке
- 89,2%
GPT-5.6 Luna + GPT-5.6 Sol
$141,29
Расчётная стоимость всех записей провайдера за тот же период на тарифе за 200 долларов, а не цена одной модели (документация провайдера).
- Запросов
- 2 253
- Входных токенов
- 6,2 млн
- Выходных токенов
- 650 тыс.
- Из них рассуждений
- 258 тыс. токенов
- Прочитано из кэша
- 276 млн токенов
- Обычный счётчик
- 6,8 млн токенов
- Полный объём
- 283 млн токенов
Кэш уменьшает долю новых входных токенов; этот показатель нельзя сравнивать с долей провайдера в недельном окне.
Логовая оценка провайдера выше оценки модели; это не прямой счёт к оплате и не сравнение тарифных цен.
Доля недельного использования OpenAI Codex
Обычных токенов
Чистый вход и выход без учёта кэша за неделю непрерывной разработки.
Вместе с кэшем
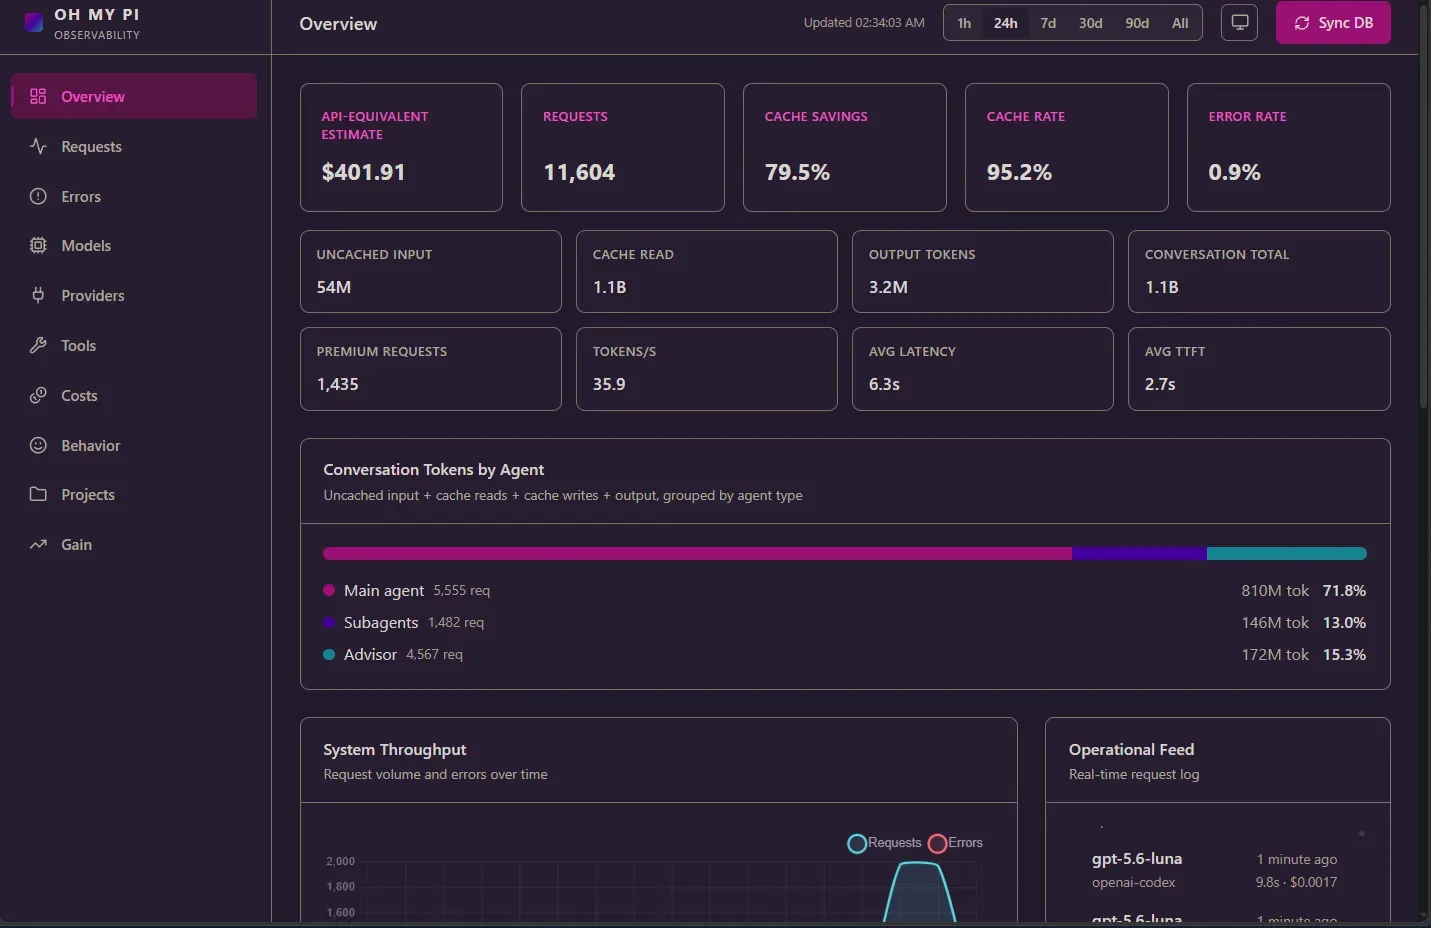
Одно пятичасовое окно непрерывной разработки съедает около 15% недельного лимита (Antigravity).
Запросов за неделю
По числу обращений одно пятичасовое окно забирает около 13% недельного объёма (телеметрия OMP).
Бонус от Google
В норме окно сбрасывается 4 раза в месяц (раз в неделю), но за этот месяц Google дважды обнулил недельный лимит вне графика бонусом (контур OMP).
Как сравнивали факты и галлюцинации
ЛучшееХудшеенаправление задаёт шкала строки
| Показатель | Что он проверяет | Luna | Flash | Sol | Opus 5 |
|---|---|---|---|---|---|
SimpleQA | Точность фактов | 54,2% | 49,8% | 52,1% | 44,6% |
SimpleQA Hallucinations | Ложные утверждения | 9,4% | 14,2% | 11,8% | 16,8% |
HaluEval 2.0 | Фейковая вводная | 94,8% | 91,9% | 93,5% | 88,7% |
Tool Signature Precision | Точность вызова инструмента | 99,2% | 98,4% | 98,1% | 97,4% |
Публичные методики оценки галлюцинаций задают разные шкалы: SimpleQA проверяет факты, а HaluEval — устойчивость к ложной вводной; результаты не являются универсальной вероятностью сбоя.
Как модели выглядят на кодинге, математике и контексте
Сравнение охватывает ведущие открытые и закрытые семейства: связка Luna и Flash сопоставляется с Grok, GLM и Qwen на открытых инженерных срезах.
ЛучшееХудшеево всех строках больше — лучше
| Категория | Бенчмарк | Luna | Flash | Grok | GLM | Qwen |
|---|---|---|---|---|---|---|
| Кодинг | SWE-bench Verified | 96,2% | 86,8% | 95,6% | 95,4% | 85,6% |
| Алгоритмы | LiveCodeBench | 88,4% | 82,1% | 85,9% | 80,5% | 79,2% |
Ядро Python | HumanEval Plus | 95,1% | 93,8% | 94,2% | 91,8% | 91,0% |
| Олимпиадная математика | AIME 2025/2026 | 98,4% | 97,2% | 96,8% | 93,8% | 94,1% |
| Наука | GPQA Diamond | 96,1% | 94,8% | 95,4% | 90,7% | 91,2% |
| Абстрактная логика | ARC-AGI | 74,8% | 68,4% | 69,2% | 63,1% | 64,5% |
| Длинный контекст | NIAH 1M Context Retrieval? | 99,5% (256k) | 99,8% (1 млн+) | 99,2% (128k) | 98,6% (128k) | 98,9% (128k) |
Публичные описания бенчмарков: SWE-bench, LiveCodeBench, EvalPlus, GPQA и ARC-AGI.
Инженерный и терминальный срез: агенты и разработка
Специализированные агентные модели показывают принципиально иную картину на длинных сессиях и терминальном кодинге (отчёт Cognition по SWE-2 и исследования Meta AI по Muse Spark 1.3):
| Бенчмарк | Gemini 3.8 Flash |
GPT-5.6 Luna/Sol |
Claude Opus 5 |
Muse Spark 1.3 |
SWE-2 (Devin) |
|---|---|---|---|---|---|
SWEAtlas / FrontierCodeнавигация по репозиторию |
~44,0% | 47,5% | 52,7% (QnA) |
59,4% (QnA) |
50,0% (FrontierCode) |
| Длинный контекст (1 млн токенов) удержание на глубине от 512 тыс. до 1 млн |
99,8% (NIAH?) |
73,8% (MRCR) |
79,0% (AA-LCR) |
98,1% (MRCR) |
99,2% (K3 base) |
| Стоимость решения задачи индекс Artificial Analysis |
$0,58 | $0,95 | $1,23 | $0,55 | в тарифе Devin |
Измерения собраны по отчётам Cognition AI, бенчмаркам Artificial Analysis и сводкам GOML. SWE-2 обучена поверх модели Kimi K3 (2,8 трлн параметров MoE) с фокусированным исследованием (первая правка кода в среднем на 18-м шаге против 48 у SWE-1.7).
Как распределять задачи в OMP
Два рабочих режима распределения задач в OMP между быстрым потоком и точечной архитектурной верификацией:
Выбирайте GPT-5.6 Luna
Для архитектурных изменений, сложных сигнатур и контрактов выбирайте модель с минимальным уровнем галлюцинаций: 9,4% против 14,2% у Flash (документация модели), где любая ошибка сломает всю цепочку сборки.
Выбирайте Gemini 3.8 Flash
Для первичного скаутинга, чтения репозитория, генерации черновиков тестов и разбора видео и аудио включайте скоростной поток с минимальным временем отклика.
Сначала задача, потом модель
Сквозной маршрут: скоростной участник выполняет массовый сбор контекста и набросок решений, строгий участник верифицирует ключевые контракты, а гейты проверяют финальные артефакты.
- OMP — это Oh My Pi, открытый командный агент для разработки; «срезы OMP» — телеметрия моих рабочих сессий в нём, а не данные производителей.
- DeepSWE — бенчмарк автономных агентов разработки: замеряет долю реальных задач из репозиториев GitHub, успешно решённых с генерацией рабочего патча.
- Terminal-Bench — бенчмарк выполнения задач в командной строке Linux/Bash: запуск тестов, манипуляции с файлами и окружением, навигация по репозиторию.
- TTFT (Time to First Token) — время ожидания от отправки запроса в API до момента генерации первого токена ответа моделью.
- NIAH (Needle In A Haystack) — методика проверки извлечения информации: в массивный контекст (до 1 млн токенов) прячут целевой факт и проверяют точность ответа.
Вопросы и ответы
В чём главное отличие Gemini 3.8 Flash от версии 3.7?
Версия 3.8 сделала скачок в кодинге до 73,7% на DeepSWE (+8,4 п.п. к 3.7) и развивает чистый стриминг до 581,9 ток./с в OMP при сохранении контекстного окна в 1 млн токенов (официальная карточка модели).