В Devin Pro за $20: минимум 8 млрд токенов SWE-2 за 14 дней
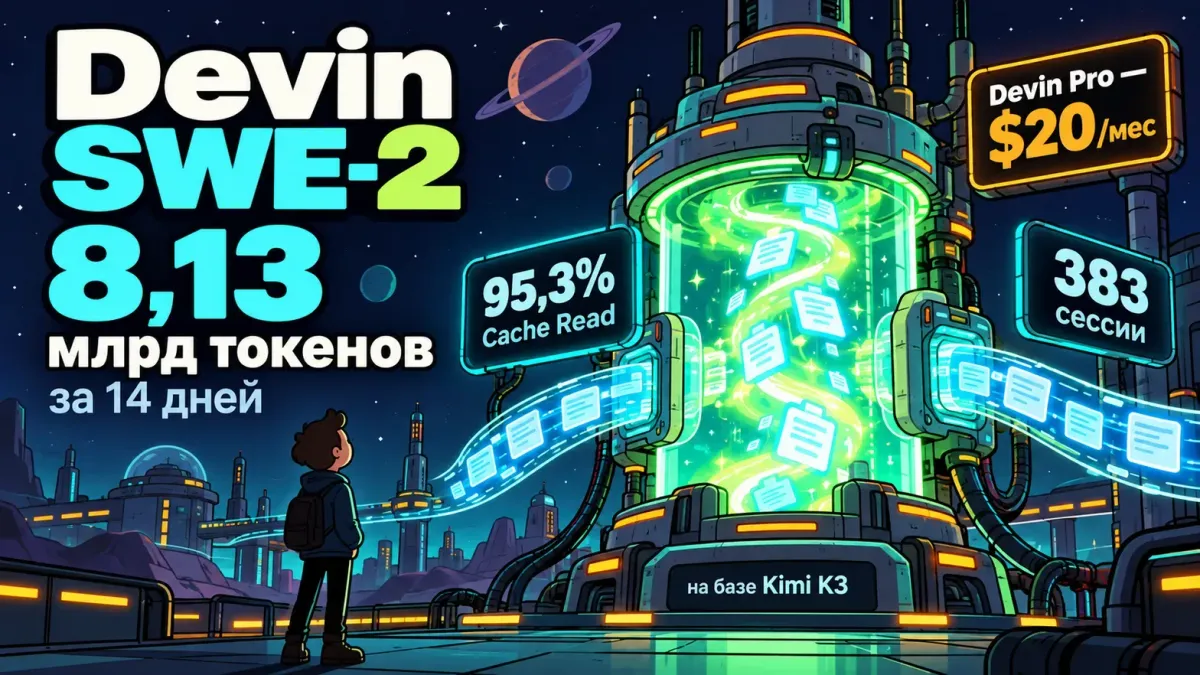
Двухнедельная телеметрия Devin SWE-2: не менее 8 млрд токенов, 95,3% — Cache Read. Devin Pro стоит $20/мес; бесплатный доступ в Desktop и CLI указан до 10 октября.
Что такое SWE-2: архитектура Kimi K3 и бенчмарки Cognition
Суть: За 14 дней прогона в подписке Devin Pro за $20 модель Devin SWE-2 перемолола 8,13 млрд токенов, но 95,3% из них — это чтение кэша. По прямым API-тарифам Kimi K3 или Claude Sonnet 4.5 этот объём стоил бы $3 790, а на DeepSeek — $457. Подписка окупается с первого дня.
10 сентября 2026 года Cognition представила SWE-2 как модель для автономного программирования, построенную поверх Kimi K3. Параметры и контекст базовой модели — в официальном описании.
По заявлению Cognition, дообучение шло через обучение с подкреплением (RL), оптимизированное под стоимость генерации токенов.
| Бенчмарк | Kimi K3 | SWE-2 | Разница |
|---|---|---|---|
DeepSWE 1.1 |
68,5% | 73,0% | +4,5 п.п. |
FrontierCode 1.1 Main |
44,2% | 50,0% | +5,8 п.п. |
Terminal-Bench 2.1 |
88,3% | 92,8% | +4,5 п.п. |
Источники: Cognition о SWE-2, DeepSWE, FrontierCode 1.1 и Terminal-Bench 2.1.
8,13 млрд токенов за 14 дней: чтение кэша, вход и генерация
Я прогонял Devin SWE-2 с 11 по 24 сентября. У меня в сводке 383 сессии и около 60,5 тыс. сообщений ассистента.
Всего Devin SWE-2 нагенерировал 8,13 млрд токенов. Из них 7,75 млрд — чтение кэша (Cache Read), 354 млн — вход, 27 млн — генерация.
В моём отчёте Billable составил 381 млн токенов.
Сколько стоил бы мой прогон по API-тарифам
| Модель и сценарий | Вход, $ за 1 млн токенов | Чтение кэша, $ за 1 млн токенов | Выход, $ за 1 млн токенов |
|---|---|---|---|
Kimi K3 API | $3,00 | $0,30 | $15,00 |
Claude Sonnet 4.5, стандартный контекст до 200 тыс. токенов | $3,00 | $0,30 | $15,00 |
GPT-5.6 Sol, короткий контекст | $4,00 | $0,40 | $20,00 |
GPT-5.6 Sol, длинный контекст | $8,00 | $0,80 | $30,00 |
DeepSeek-V4-Pro-0813, непиковый тариф | $0,66 | $0,022 | $1,98 |
DeepSeek-V4-Pro-0813, пиковый тариф | $1,32 | $0,044 | $3,96 |
| Модель и сценарий | Расчёт по моим счётчикам, $ |
|---|---|
Kimi K3 API | $3 790,24 |
Claude Sonnet 4.5, стандартный контекст до 200 тыс. токенов | $3 790,24 |
GPT-5.6 Sol, короткий контекст | $5 053,65 |
GPT-5.6 Sol, длинный контекст | $9 837,26 |
DeepSeek-V4-Pro-0813, непиковый тариф | $457,40 |
DeepSeek-V4-Pro-0813, пиковый тариф | $914,80 |
Ставки взяты из тарифов Kimi K3, прайса Anthropic, тарифов OpenAI и тарифов DeepSeek. Запись в кэш, вызовы инструментов и налоги в расчёт не входят.
Как SWE-2 отвечает в моём прогоне
| Замер | p50 | p90 | p95 | p99 |
|---|---|---|---|---|
| TTFT, с | 5,668 | 15,386 | 20,086 | 38,079 |
| Полный ход, с | 6,992 | 24,577 | 38,657 | 88,566 |
Для парного кодинга в реальном времени не годится: хвост TTFT и полного хода закрывает интерактив — только фоновые агентные прогоны.
Динамика по дням: пик 18 сентября — 1,89 млрд токенов
| Дата | Сообщения | Все токены | Billable, млн токенов |
|---|---|---|---|
| 11.09.2026 | 110 | 12,8 млн | 0,4 млн |
| 13.09.2026 | 96 | 11,0 млн | 0,3 млн |
| 14.09.2026 | 1 970 | 250,1 млн | 9,6 млн |
| 15.09.2026 | 5 159 | 613,0 млн | 24,0 млн |
| 16.09.2026 | 3 492 | 454,8 млн | 19,8 млн |
| 17.09.2026 | 7 065 | 916,6 млн | 58,7 млн |
| 18.09.2026 | 13 109 | 1 892,2 млн | 48,4 млн |
| 19.09.2026 | 9 875 | 1 322,7 млн | 49,1 млн |
| 20.09.2026 | 3 721 | 514,6 млн | 32,8 млн |
| 21.09.2026 | 3 529 | 506,6 млн | 46,8 млн |
| 22.09.2026 | 4 856 | 691,7 млн | 34,0 млн |
| 23.09.2026 | 6 124 | 769,1 млн | 46,8 млн |
| 24.09.2026 | 1 386 | 171,3 млн | 10,1 млн |
Как SWE-2 ведет себя у людей — и у меня
Бенчи Cognition — это одно, а люди говорят другое, и я с людьми согласен. Независимый KingBench 3 дал SWE-2 83,75% против 81,25% у DeepSeek V4.1 Flash: три победы, два поражения, три ничьи. Вроде ок, но это восемь игрушечных задачек. А на Terminal-Bench 4, который вне прикормленной дистрибуции, SWE-2 сливает GPT-6 Astra 27,3% против 57,9% — и это официальные цифры самой Cognition.
«swe-2 is heavily benchmaxed... the instant it encountered a bench outside its distribution it failed spectacularly... i hate benchmaxed models» — davidbandel, daily.dev
Дальше живые жалобы. Тред в r/DevinAI так и называется: «SWE-2 is basically unusable for me because of how slow it is» — совет из треда: сидеть на medium/high, на max одна простая задача жрется часами. Это ровно мои p99 38/89 секунд, только словами людей. Вторая жалоба: модель задает слишком много уточняющих вопросов перед стартом — для автономного агента это трение. Третья: путаница с безлимитом — у людей стопалась работа через полчаса, оказалось что unlimited только local CLI/Desktop треды, Cloud не в счет.
«The model talks the closest to how a human talks. No unnecessary information, over-the-top phrasing and verbosity... I kept running the same tasks with both SWE-2 Max and Fable 5.1 Max and the results were very similar» — Catalin Pit, неделя на реальном Documenso
Этот же человек независимо пришел к моей схеме: frontier-лид планирует, SWE-2 таскает код. У Cognition это даже фирменный режим называется — Fusion. Дальше мой опыт за 383 сессии и 60,5 тыс. сообщений этого прогона, без прикрас. Я много гонял эту модель. Как мейн-агента ее использовать нельзя — только сабагент с четким скоупом и инструкциями. Не давай ей придумывать функционал, архитектуру или документацию, иначе получишь исследования ради галочки, абстракции глубиной в лужу и велосипеды с костылями. Ей хоть сто раз скажи «работай в OOP, SOLID, DRY, KISS, DDD, TDD, BDD» — в моих прогонах она все равно перепрыгивала через red-фазу TDD, игнорила OOP и не видела Single Responsibility, пока не ткнешь в упор. За ней нужен ревью, всегда. А если посадить ее мейн-агентом на каждый день — ругань в чате обеспечена в большом объеме.
Для сравнения, Gemini 3.8 Flash — быстрый, но тупее: поток 239 токенов в секунду против 213 у DeepSeek V4.1 Flash, зато на агентских бенчах сливает — Terminal-Bench 4.0 19,7% против 26,8%, AutomationBench 59,9% против 68,9%, а время до первого токена вообще 14,93 секунды против 1,09. По моим задачам та же картина: отвечает мутно, как Opus 4.5, постоянно приходится переспрашивать «объясни нормально», плюс регулярно косячит с мерджами и работой в worktree. В агрегате BenchLM на 30 сентября расклад такой: Gemini 3.8 Flash — 73,92, Kimi K3 — 72,12, Sonnet 4.5 — 49,13. Про Kimi K3 честно: я ее в таком объеме не гонял, но гонял SWE-2, который форк Kimi K3. Хайпанула она так, что продажи закрыли. Но если SWE-2 это плюс-минус уровень Kimi K3 — то это печаль, потому что это максимум Sonnet 4.5. А про Sonnet я ничего хорошего сказать не могу: опыт с ней большой и полностью негативный.
Примечания
- Специализированная агентная модель Cognition для программной инженерии; заявления об обучении и бенчмарках атрибутированы Cognition.
- Базовая модель семейства Mixture of Experts от Moonshot AI; официальное описание указывает 2,8 трлн параметров и контекст до 1 млн токенов.
- Чтение из кэша дешевле входа в 10 раз: $0,30 против $3,00 за 1 млн токенов у Kimi K3 и Claude Sonnet 4.5. Поэтому доля 95,3% и решает экономику прогона.
- Время от отправки запроса до первого сгенерированного токена ответа.
- Имя счётчика в исходной сводке для суммы входных и выходных токенов.
Сколько токенов SWE-2 зафиксировано за две недели?
В локальной сводке за 11–24 сентября 2026 года указано около 8,13 млрд токенов. Показатель Cache Read — число токенов, прочитанных из кэша, — составляет 95,3% общего объёма. Это 14-дневный срез; полнота данных за 24 сентября не указана.
Что означает Devin Pro за $20 и безлимитный SWE-2 до 10 октября?
Devin Pro стоит $20 в месяц и включает квоты, которые обновляются ежедневно и еженедельно; сверх квоты можно докупить дополнительный объём по API-тарифам. Владелец поста сообщает о безлимитном SWE-2 в своём аккаунте до 10 октября 2026 года. Публичная страница Devin подтверждает бесплатный доступ к SWE-2 в приложении для компьютера и командной строке до этой даты, но не утверждает, что доступ безлимитный.
Доказывают ли расчёты стоимости API экономию на Devin Pro?
Нет. Это условный пересчёт локальных счётчиков по публичным API-тарифам, а не счёт Devin или измерение экономии. В сводке не указаны объём записи в кэш, распределение контекста, остаток квоты и фактические доплаты.
Как распределилась задержка SWE-2 по процентилям?
В моей сводке медиана времени до первого токена — 5,7 секунды. На 90-м процентиле — 15,4 секунды, на 95-м — 20,1, на 99-м — 38,1. Полный ход занимал медианно 7,0 секунды; на 90-м процентиле — 24,6 секунды, на 95-м — 38,7, на 99-м — 88,6.